Словниковий запас
Скільки слів, щоб читати іспанські романи?
«3 000 слів = роман» - це міф. Для іспанських романів важить покриття тексту, реалістичні діапазони слів і перевірка книги на середніх сторінках.
Ви відкриваєте іспанський роман. У застосунку «вже 3 000 слів». А на 12-й сторінці - стіна: минулий час, займенники, щільний абзац, і сюжет розсипається.
Це не «немає таланту». Це майже завжди неправильний критерій. Застосунки продають трофейну цифру. Дослідження читання говорять про покриття (яку частку слів у тексті ви вже знаєте) і про діапазони, не про долю.
Пряма відповідь. Немає однієї магічної квоти слів «для будь-якого іспанського роману». Ціліться у високе покриття на книзі перед вами: у дослідженнях часто обговорюють близько ~95% (важко, приблизно 1 невідоме на 20 слів) і ~98% (комфортніше для самостійного читання). Класичні оцінки в стилі Nation (здебільшого англійські корпуси) пов'язують ~95% романів/новин із приблизно ~4 000 сімей слів, а ~98% - із приблизно ~8 000-9 000 сімей. Для іспанської беріть це як масштаб порядку, не як автомат із лемами. Перевірка - 10-хвилинний тест середніх сторінок, далі драбина: graded → міст-роман → обсяг.
Коротко: судіть іспанський роман за густиною невідомого на середніх сторінках, не за трофейним Anki-тоталом.
Що буде далі:
- Що означають ~95% і ~98% людською мовою
- Що насправді кажуть цифри Nation і як застосувати їх до іспанської
- Чому «я знаю 3 000» ламається на 12-й сторінці
- Тест середніх сторінок і шлях від адаптацій до роману
- Де інструменти допомагають, а де підміняють науку
М'який старт для карти: скільки слів для CEFR і карта лексики.
Спочатку покриття, потім лічильник слів
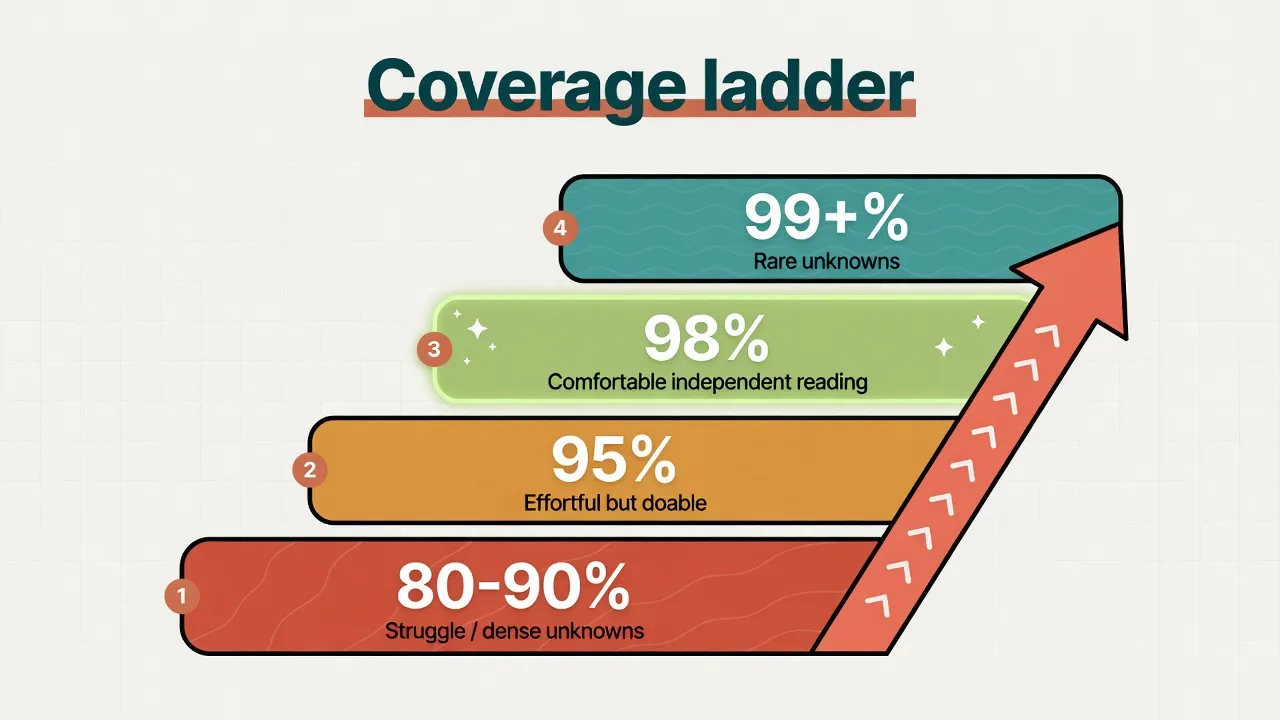
Покриття - частка слів (токенів) у тексті, які ви вже знаєте. Не «скільки карток у колоді», а «скільки на цій сторінці вже ваше».
| Покриття (приблизно) | Частота невідомого | Як зазвичай читається |
|---|---|---|
| ~80-90% | 1 невідоме на 5-10 слів | Постійне декодування; це ще не читання |
| ~95% | близько 1 на 20 | Можливо з зусиллям; багато хто все одно втомлюється |
| ~98% | близько 1 на 50 | Значно комфортніше самостійне читання |
| ~99%+ | рідко | Легке extensive reading для цього тексту |
Роботи на кшталт Hu & Nation (2000) і пізніші дослідження покриття (зокрема Schmitt та колеги) підтримують просту ідею: вище покриття зазвичай = краще розуміння. Близько ~98% частіше обговорюють як безпечніший орієнтир для комфортного самостійного читання складного тексту; ~95% - «адекватно, але важко». Люди, жанри й знання теми різняться.
Тож якщо блог пише «точно 95,000% - магічний перемикач», ігноруйте фейкову точність.
Що насправді кажуть цифри в стилі Nation
Класична кількісна робота здебільшого про англійську. Це орієнтири-діапазони, не іспанський закон.
| Ціль | Приблизний розмір (сім'ї слів) | Нотатки |
|---|---|---|
| ~95% покриття кількох романів/газет | часто близько ~4 000 сімей (+ власні імена як відомі) | Усе ще ~1 невідоме на 20 токенів |
| ~98% покриття романів/газет | часто ~8 000-9 000 сімей (+ власні імена) | Ближче до комфортного самостійного читання |
| ~95% розмовної англійської | часто нижче, ніж у романів (тисячі, не 9k) | Розмова ≠ літературна проза |
| ~98% розмовної | все ще великий обсяг, але зазвичай нижче «романних» 98% | У слухання свій профіль |
Як користуватися цим для іспанської:
- Іспанські романи - не англійські, але принцип покриття переноситься: більшість слів у тексті мають бути знайомими.
- Точні заяви «вам треба 8 472 іспанські леми» майже завжди маркетинг.
- Сучасна YA з діалогами може відчуватися легшою за щільну класику при тому самому «розмірі словника».
- Знання теми (детектив, школа, романтика) може замінити сотні рідкісних слів.
Про покриття й розуміння тексту: словник для reading comprehension. Про міф «5 000 = C2»: чи означають 5 000 слів C2.
Практичне читання іспанською: діапазони, не гарантії
| Ціль читання | Груба рецептивна зона (що часто кажуть/потрібно) | Ціль покриття на цій книзі |
|---|---|---|
| Graded A1-A2 статті | високочастотне ядро (сотні до ~1-2k сімей у роботі) | достатньо, щоб дочитувати сторінки |
| Легкі learner-романи / дуже проста YA | часто середні тисячі рецептивно | спробуйте відчуття ~95%+ |
| Звичайні сучасні романи | кілька тисяч сімей; комфорт ближче до 98% може потребувати великого лексикону | краще ~98% на пробних сторінках |
| Літературна класика, експериментальна проза | вище; стиль б'є «сирі списки» | спершу семпл, потім зобов'язання |
У навчальній культурі іспанської часто згадують близько ~5-8k для «комфортних автентичних романів». Це смуга з досвіду учнів, не офіційна квота Сервантеса. Усе одно підпорядковуйте її покриттю на сторінці.
Обережність із частотністю: топ-1 000 може давати великий token-share і все одно провалюватися як справжнє читання роману.
Одне речення на згадку: судіть цю книгу за густиною невідомого, не за універсальним трофеєм слів.
Сім'ї слів vs форми: чому застосунки й блоги сваряться
Сім'я слів
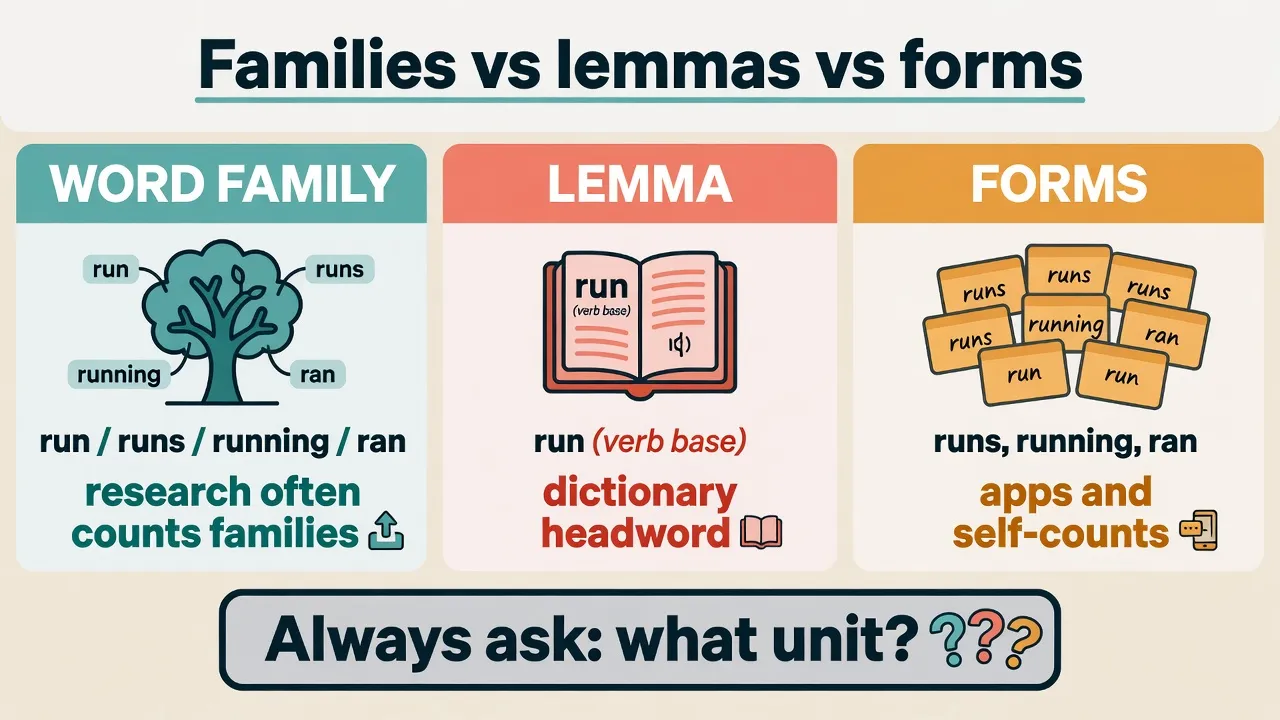
У дослідженнях покриття часто рахують сім'ї: correr / corrió / corriendo / corredor - одна сім'я, не чотири «нові слова з нуля».
Лема / словоформа
Словники й багато застосунків ближчі до лем (базова форма). Self-count і Anki часто рахують форми або картки - найбрудніша одиниця; саме вона роздуває «я знаю 3 000».
| Одиниця | Хто так рахує | Чому цифри розходяться |
|---|---|---|
| Сім'я слів | Дослідження coverage | Багато форм = одна сім'я |
| Лема | Словники, чимало app | Базова форма; не кожне написання |
| Форма / картка | Anki, self-count | Найбрудніше; завищує «3 000» |
Правило: перш ніж порівнювати Anki з «романом треба N слів», запитайте: яка одиниця?
Когнати (особливо EN→ES) допомагають нерівномірно. Власні імена бувають легкими або ні. Детальніше: лема vs словоформа, карта лексики, як працює карта.
Чому «я знаю 3 000 іспанських слів» ламається на 12-й сторінці
Три типові розриви:
- Впізнавання vs швидкість читання - «знаю» зі списку ≠ встигаю в морфологічно щільній іспанській.
- Не ті 3 000 - туристичні слова ≠ функціональні слова роману, літературні дієслова, маркери дискурсу.
- Кластери щільності - сцена бою чи «юридичний» підсюжет може вилити 15 невідомих в один абзац, навіть якщо середнє по розділу виглядало нормально.
Специфічне тертя іспанською для багатьох:
- морфологія минулого часу в наративі
- об'єктні займенники й кластери клітик
- регіональний діалог
- узгодження роду/числа, яке гальмує розбір
Розмір словника допомагає. Він не є всією навичкою читання. Кращий компас - тест середніх сторінок нижче.
Кращий тест, ніж віральний квіз (середні сторінки)
Забудьте сайти, що за 20 питань і share-картку «видають» ваш CEFR і готовність до роману. Це розвага, не вимірювання.
10-хвилинний протокол
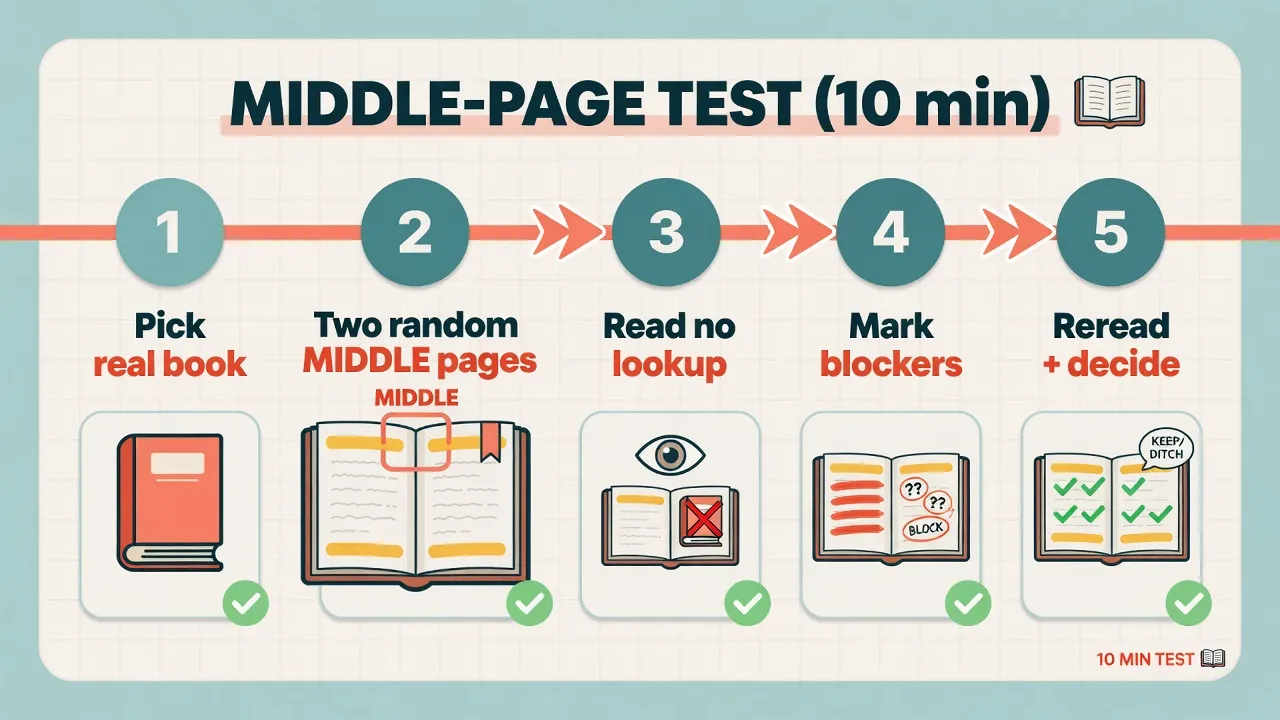
- Візьміть реальний формат (семпл EPUB, прев'ю в магазині, бібліотечна позика).
- Відкрийте дві випадкові середні сторінки - не відполіровану першу.
- Прочитайте один раз без словника.
- Позначте лише слова/фрази, що зламали зміст.
- Перечитайте.
- Повторіть на другій книзі-кандидаті.
| Результат | Що це значить | Наступний крок |
|---|---|---|
| Блокерів мало; сюжет ясний | Хороший основний роман | 15-25 хв щодня |
| Сюжет ясний; багато підглядів | Роман із підтримкою (OK) | Обмежте lookups; через день - graded |
| Сюжет каламутний навіть після lookups | Stretch-проєкт | Легший роман або graded-міст |
| Паніка / хочеться кинути | Зараз не та книга | Без сорому - змініть input |
Один роман може «йти», інший - стіна. Десять хвилин чесності дешевші за тиждень самообману.
Реалістичний шлях до іспанських романів
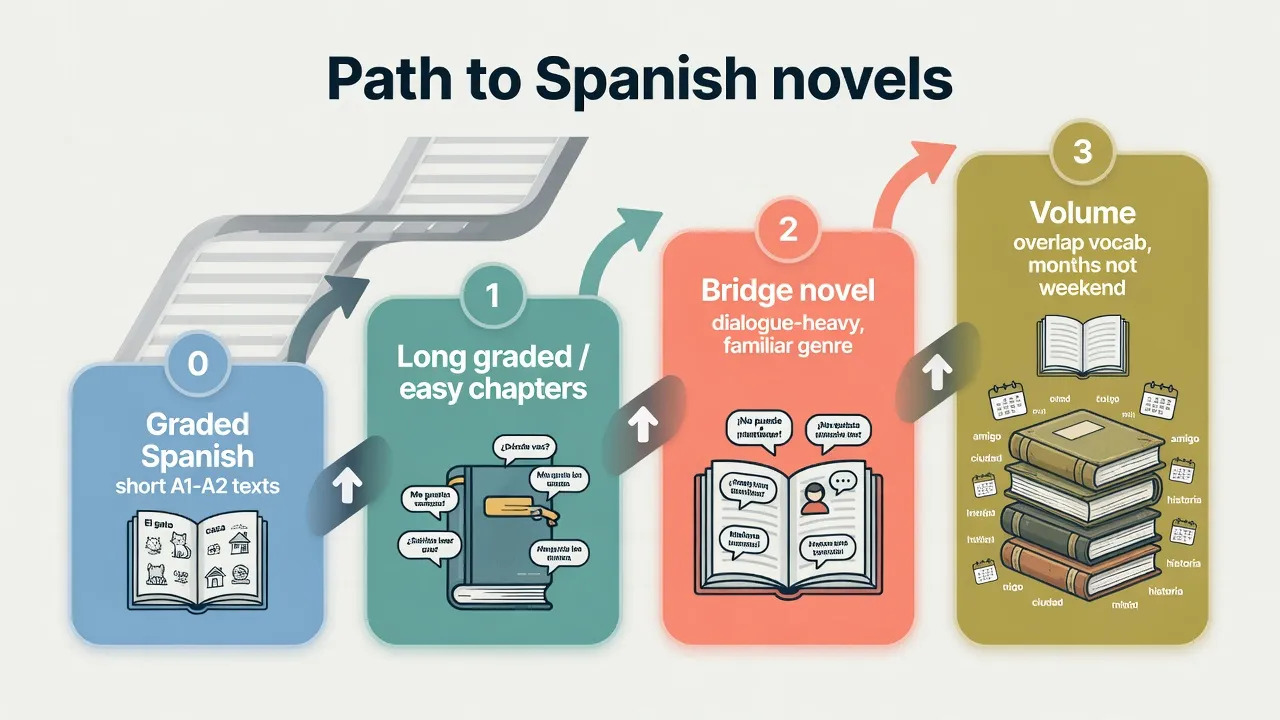
Жодних «роман за вихідні». Місяці стабільного читання, не челлендж у стрічці.
Етап 0 - короткі graded-тексти
Мета: дочитувати сторінки, а не розшифровувати літери.
- Безкоштовні рівні статті щодня
- Семпли: A1, A2
- Бібліотека: усі статті
Етап 1 - довгі graded / легкі chapter books
Мета: історії на кілька сідань із високим покриттям.
- Learner-романи, щоденники, проста YA іспанською
- Та сама дисципліна lookups: лише блокери
Списки стартів: 10 найлегших іспанських книг A2-B1, адаптовані vs оригінал на A2. Для A1 і B1: легкі іспанські A1, іспанські книги B1.
Етап 2 - міст-романи
Мета: перший повний популярний роман з підтримкою.
- Чіткий сюжет, багато діалогу, знайомий жанр
- Повільніший темп - нормально
- Опційно: завантажте легальний EPUB, який ви маєте, у рідер із клік-перекладом (як користуватися)
Маркес і магічний реалізм - stretch, не день перший: звідки стартувати з Маркесом.
Етап 3 - обсяг
Мета: другий і третій роман стають легшими через перетин лексики, а не тому що лічильник «дістався магії».
Про час: від «A2-стаття» до «комфортний сучасний роман» у багатьох ідуть місяці регулярного читання.
Скільки слів на тиждень?
Дослідження extensive reading більше люблять повторні зустрічі в контексті, ніж 50 ізольованих іменників на день.
Практичні стелі, які не вбивають читання:
- Зберігайте 3-10 корисних фраз за сесію
- Краще chunks (dar por hecho, a pesar de), ніж сирі леми
- Перечитайте вчорашню сторінку, перш ніж навантажувати нову
Якщо ви кинули книгу заради «ідеальної» Anki-колоди - оптимізували не той метрик.
Опційно: graded-історії за CEFR, intensive vs extensive іспанською.
Мітки CEFR vs покриття на сторінці
CEFR - розмовна мітка / can-do, не офіційний закон слів. Навчальні матеріали все одно користуються грубими смугами. Обережна версія:
| Зона | Очікування від читання (дуже приблизно) |
|---|---|
| A2 | Короткі graded; романи як щоденний драйвер зазвичай важкі |
| B1 | Прості історії й романи з сильною підтримкою можливі |
| B2 | Багато сучасних романів читабельні з зусиллям; літературна щільність різна |
| C1+ | Широкий діапазон романів; біль лишається в стилі, культурі й витривалості |
Рішення = покриття на сторінці, не диплом.
Пов'язані статті: скільки слів CEFR, скільки слів для B2, Plan Curricular іспанської, 5 000 = C2?, карта, як працює карта.
Де інструменти допомагають (і де підміняють)
Корисно:
- миттєвий lookup, щоб рідкісне слово не вбило сесію
- збереження фраз із живих речень
- аудіо, коли сторінку вже тягнете (на безкоштовному плані прослуховування без ліміту)
- graded-бібліотеки, що навмисно піднімають покриття
- EPUB, який ви маєте, з клік-перекладом на етапі 2
Перепродано / не купуйте обіцянки:
- персональні «94,3% покриття роману» як аналіз крові
- гарантії «N слів = fluency за N днів»
- англійські цифри Nation як точна доля іспанських лем
- віральний «ваш рівень» із 20 питань
Як використати MovaReader для цієї мети
- Будуйте покриття на безкоштовній graded-іспанській: усі статті, семпли A1 і A2.
- Безкоштовний план: ~20 перекладів/день, прослуховування без ліміту. Коли lookups - вузьке місце, Reader €1 (безліміт перекладів).
- На етапі 2 завантажте EPUB роману, який ви маєте (як користуватися).
- Опційно Pro €5/міс для повних тренажерів; тримайте малий набір фраз (3-10/сесію). Демо: phrase typing.
- Карта лексики - компас орієнтації, не сертифікат «готовий до роману».
Коли ліміти реальні - тарифи. Акаунт - реєстрація, якщо потрібні особисті позначки прогресу.
Поширені міфи
«Дістався 5 000 слів - будь-який іспанський роман ок»
Ні. Cien años de soledad і сучасний трилер - різні види спорту. Жанр і щільність вирішують. Див. також 5 000 ≠ C2.
«Якщо перевожу кожне невідоме - я вчуся ефективно»
Часто ви тренуєте словник, а не дочитування сцен. Краще закінчити сцену, ніж зібрати 40 orphan-карток.
«Носії знають 100% лексики роману»
Ні. Вони теж пропускають, здогадуються й тримають неповні значення - із кращою граматичною опорою й світом знань.
«Іспанська легка через когнати, тож цифри Nation не стосуються»
Когнати допомагають (особливо з англійської), але покриття все одно має значення. Не беріть когнати як дозвіл стартувати з найважчої класики.
«1 000 найчастіших слів майже вистачає для романів»
Велика частка токенів ≠ читабельний роман. Середня й низька частота, стиль і жанр досі б'ють.
FAQ
Скільки іспанських слів треба, щоб читати роман?
Однієї цифри немає. Ціліться у високе покриття на цій книзі (у дослідженнях часто ~95-98%). Класична англокорпусна робота в стилі Nation пов'язує ~95% романів/новин із ~4 000 сімей, а ~98% - із ~8 000-9 000 сімей. Для іспанської - масштаб, не доля. Перевіряйте середніми сторінками.
Чи вистачає 95% покриття?
Іноді для адекватного розуміння з зусиллям (~1 невідоме на 20). Багато дослідників обговорюють ~98% як комфортніше для самостійного складного тексту. Спробуйте обидва відчуття на реальних середніх сторінках. «Точно 95%» - маркетинг.
Чи треба 98%, перш ніж відкривати будь-який роман?
Ні. Підтримувані романи можна раніше, якщо мотивація висока. Тримайте graded у міксі, щоб не лише страждати. Покриття цієї книги важливіше за «дипломний» поріг.
Чи вистачить 5 000 слів для будь-якого іспанського роману?
Немає гарантії. Жанр і щільність різняться (Cien años vs сучасний трилер). «5 000 слів» залежить і від одиниці (форми / леми / сім'ї). Див. чи 5 000 = C2 і міфи вище.
Списки слів чи читання - що швидше ростить словник для романів?
Для середньої й низької частоти роману читання + вибірковий повтор зазвичай б'є ізольовані списки. Списки все ще корисні, щоб закрити дірки високочастотного ядра. Краще 3-10 корисних фраз/сесію й chunks, ніж сирі orphan-леми.
Чи покаже MovaReader точний розмір словника або % покриття роману?
Ні. Користуйтеся безкоштовним планом (~20 перекладів/день, прослуховування без ліміту), Reader €1, коли lookups стають вузьким місцем, і EPUB, який ви маєте, на етапі міст-роману. Особистий прогрес - позначки + звичка читати, не сертифікат.
Фінальний висновок
Оптимізуйте покриття й звичку, не трофейний лічильник слів.
- Думайте діапазонами ~95-98%, не фейковою точністю.
- Nation ~4k / ~8-9k сімей - англокорпусний масштаб для іспанської, не торговий автомат.
- Тестуйте середні сторінки реальної книги.
- Драбина: graded → міст-роман → обсяг.
- Lookups і free-бібліотеки тримають сесію живою; платіть, коли ліміти реальні (тарифи).
Конкретний наступний крок: одна безкоштовна іспанська A2-стаття, потім дві середні сторінки книги, яку реально хочете. Нехай густина невідомого - не віральне число - обирає шлях. Орієнтація по смугах: карта лексики.
Читай далі з перекладом просто в тексті
З безкоштовним акаунтом незнайоме слово перекладається одним дотиком, а слова, які ти вчиш, чекають на тебе в тренажері.
Безкоштовний акаунт: 7 днів Pro, далі 20 перекладів слів на день або платний тариф.